『医学統計入門』 〜医学情報の正確な理解のために
『医学統計入門』 〜医学情報の正確な理解のために
1.医学統計は、論文と臨床をつなぐ言葉
医学論文を開くと、平均値、標準偏差、回帰係数、95%信頼区間、p値など、さまざまな数値が登場します。授業で計算方法を学んでも、実際の論文を前にすると、どこから読めばよいか迷うことがあります。
医学統計を理解する出発点は、用語を正確に理解することと、それぞれの数値が「何を知るためのものか」を区別することです。 例えば、新しい薬が症状を改善したという研究では、まず「どのくらい改善したのか」を知る必要があります。次に「その推定はどの程度確かか」を考えます。そして「患者さんにとって意味のある改善か」を判断します。
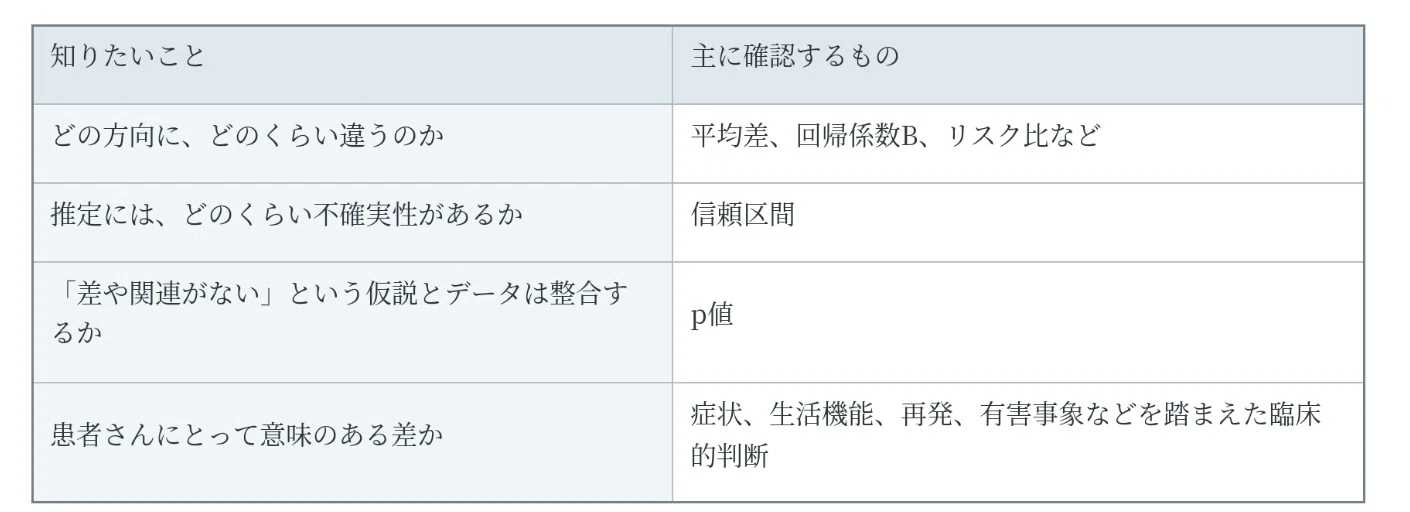
これらの役割を押さえると、論文の数値が臨床的な意味を持って見えてきます。
2.母集団と標本 〜一部の患者から全体を推測する
ある抗うつ薬の効果を調べたいとしても、その薬を使う可能性のあるすべての患者さんを研究に参加させることはできません。そこで、条件に合う患者さんの一部を調べます。
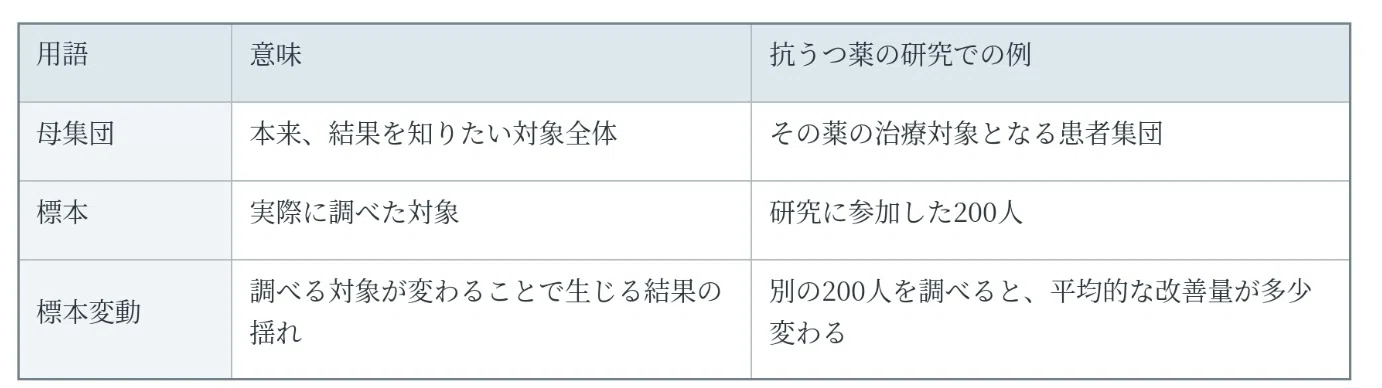
研究に参加した200人の結果から、対象となる患者集団での治療効果を推測するわけです。医学統計は、標本変動を考慮しながら、母集団について推測する方法を提供します。
一方、参加者が若く身体的に健康な患者さんに偏っていれば、高齢で身体合併症のある患者さんにも同じ結果が当てはまるとは限りません。 計算の正しさと、結果を当てはめられる範囲は、別々に考える必要があります。
3.平均値と中央値 〜典型的な患者像をつかむ
最初に確認したいのは、データを要約する基本的な数値です。
平均値は、すべての値の合計を人数で割ったものです。中央値は、小さい順に並べたとき、中央に位置する値です。 例えば、5人の入院期間が次のようだったとします。
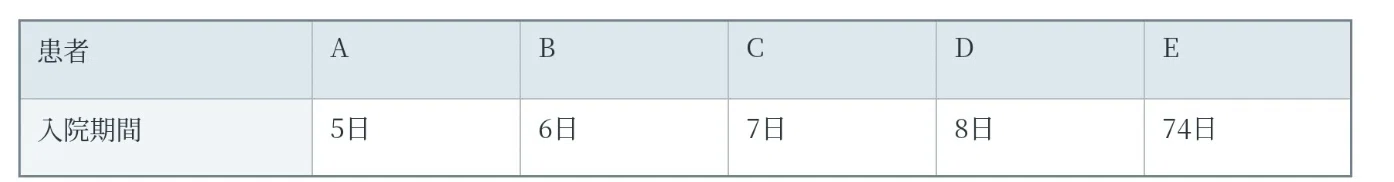
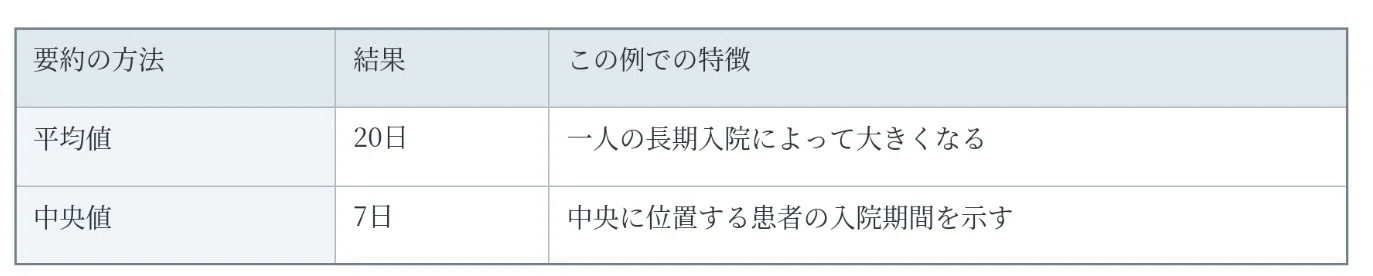
大部分の患者さんは1週間ほどで退院していますが、一人の長期入院によって平均が大きくなっています。 入院期間や医療費など、少数の大きな値を含みやすいデータでは、中央値が実態をつかむ助けになります。 中央値とともによく示される「四分位範囲」は、下位25%の位置から上位25%の位置までの範囲です。中央の50%の患者さんが、どの範囲に分布しているかを表します。
平均や中央値を見たら、同時に分布やばらつきにも目を向けることが大切です。
4.標準偏差と標準誤差 〜何のばらつきなのか
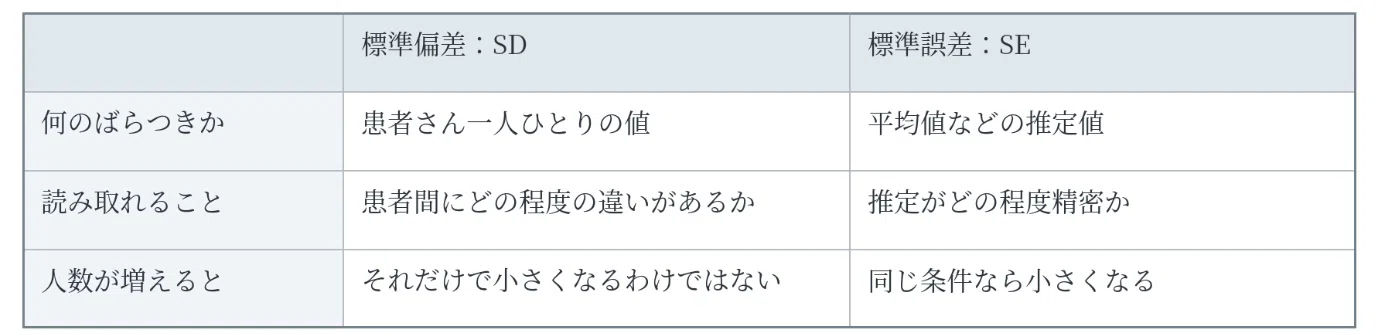
標準偏差はSDと略され、患者さん一人ひとりの値のばらつきを示します。 症状得点が平均20点、SDが5点で、おおむね正規分布なら、約68%が15~25点、約95%が10~30点に入ります。
これに対し、標準誤差、SEが表すのは、平均値などの推定値の揺れです。
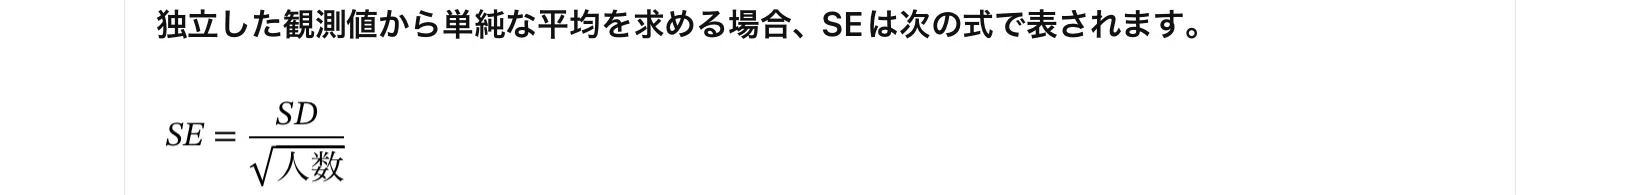
SDが10点の場合、人数によって平均値のSEは次のように変わります。
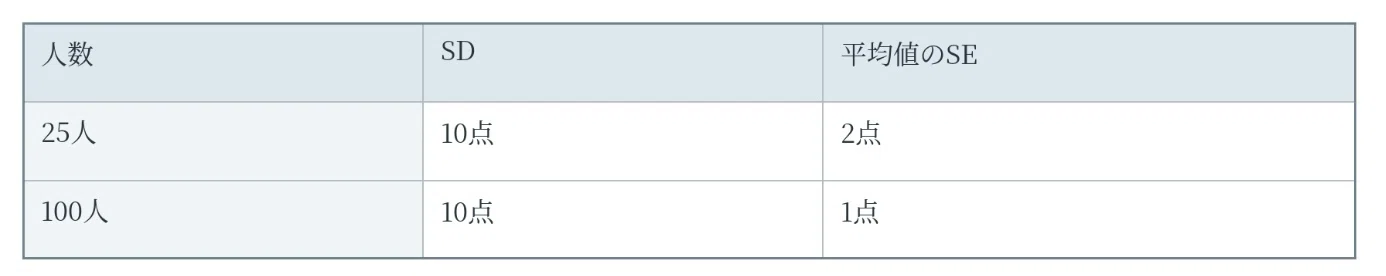
人数が増えても、患者さん同士の違いが小さくなるわけではありません。平均をより精密に推定できるようになります。 論文の「平均±数値」がSDなのかSEなのかで意味が変わるため、表の注記まで確認しましょう。
5.95%信頼区間 〜推定には幅がある
ある治験で、8週後の症状得点の群間差が「薬剤群-プラセボ群=−3点、95%信頼区間−5~−1点」と報告されたとします。得点が低いほど症状が軽い尺度です。 中心となる推定は、薬剤群のほうが平均3点低いという結果です。 信頼区間は、その推定にどの程度の不確実性があるかを示します。実用的には、採用した解析モデルと前提のもとで、データと整合的な効果の範囲として読みます。 厳密には、同じ方法で標本抽出と区間推定を繰り返したとき、作られた区間の約95%が真の値を含む、という意味です。
「患者さんの95%が1~5点改善する」という意味ではありません。ここで推定しているのは平均的な群間差です。
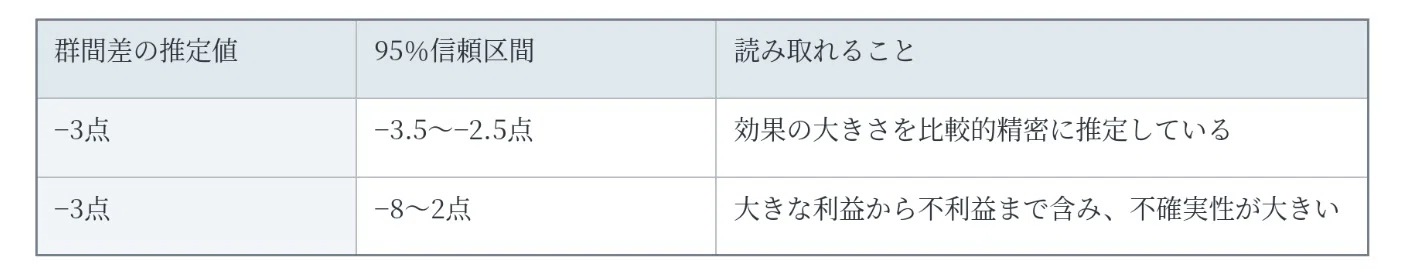
区間の幅だけでなく、その両端が臨床的に何を意味するかを考えます。 区間の幅が大きい場合は、推定値の値自体の信頼性は低くなります。しかし、0を含まない場合は、結果の方向性(改善したか、悪化したかの方向性)の信頼度は保たれるため、0を含むかどうかは重要です。(比の場合は1を含むかどうか)
6.p値 〜「差がない」という仮説との整合性
p値を理解するには、「帰無仮説」という考え方が必要です。 通常は「両群の平均に差がない」「二つの変数に関連がない」といった仮説を指します。 p値は、帰無仮説と解析の前提が正しいとしたとき、観測された検定統計量と同程度以上に極端な値が得られる確率です。
まず、本当の差や関連はないと仮定します。 その仮定と解析の条件のもとで、研究結果がどのくらいばらつくかを考えます。 そして、今回の結果が、そのばらつきの中でどの程度珍しい位置にあるかを計算します。 p=0.03とは、今回と同程度以上に極端な結果が、その仮定のもとでは約3%の頻度で生じるという意味です。
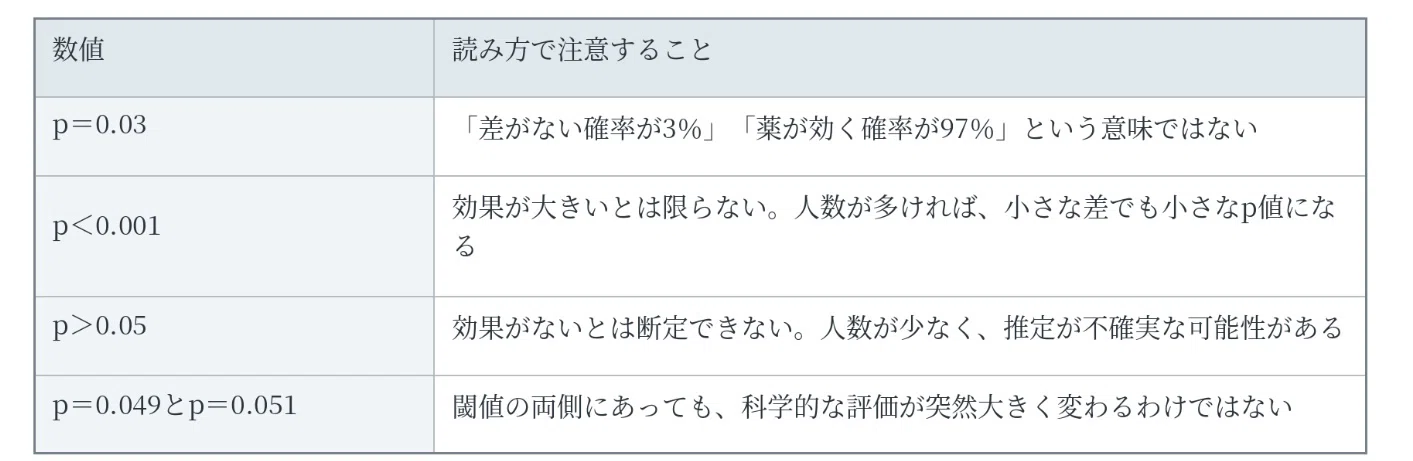
p値は連続した数値として読む必要があります。
7.信頼区間とp値を一緒に読む
同じ解析に対応する通常の両側検定では、平均差や回帰係数の95%信頼区間が0を含まなければ、p<0.05になります。リスク比やオッズ比では、差がないことを示す値は1です。
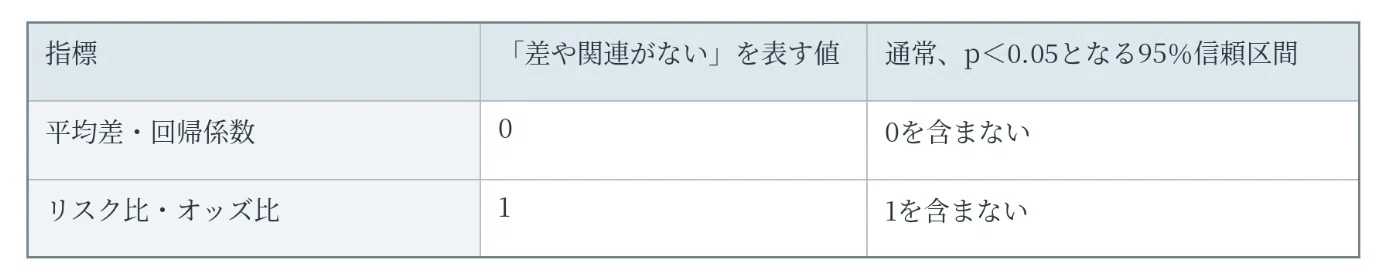
ただし、「0を含むか」だけで信頼区間を読むのはもったいない使い方です。
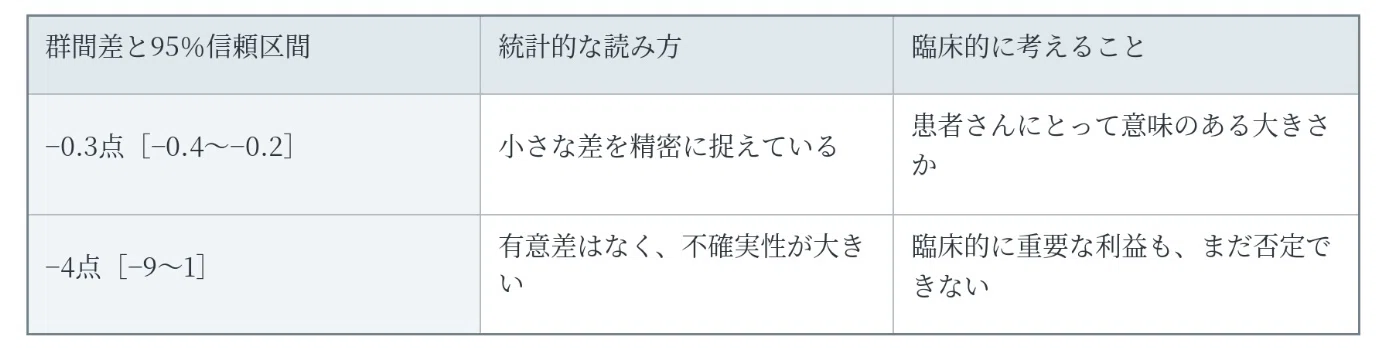
p値が示す判定と、信頼区間が示す効果の範囲を合わせて読むことで、研究結果の意味が明確になります。
8.回帰係数B 〜一単位の違いに対応する結果の違い
回帰分析は、結果と、それに関連する変数との関係を数式で表す方法です。
例えば、線形回帰で次の式が得られたとします。 症状得点=30-2×睡眠時間 この場合、睡眠時間の回帰係数Bは−2です。
睡眠時間が1時間長い人では、症状得点が平均2点低いという関連を表します。 観察研究なら、この数値だけで「睡眠を1時間延ばすと症状が2点改善する」とは言えません。症状が軽いから眠れるという逆方向の関係も考えられます。
Bを読むうえで決定的に重要なのが単位です。
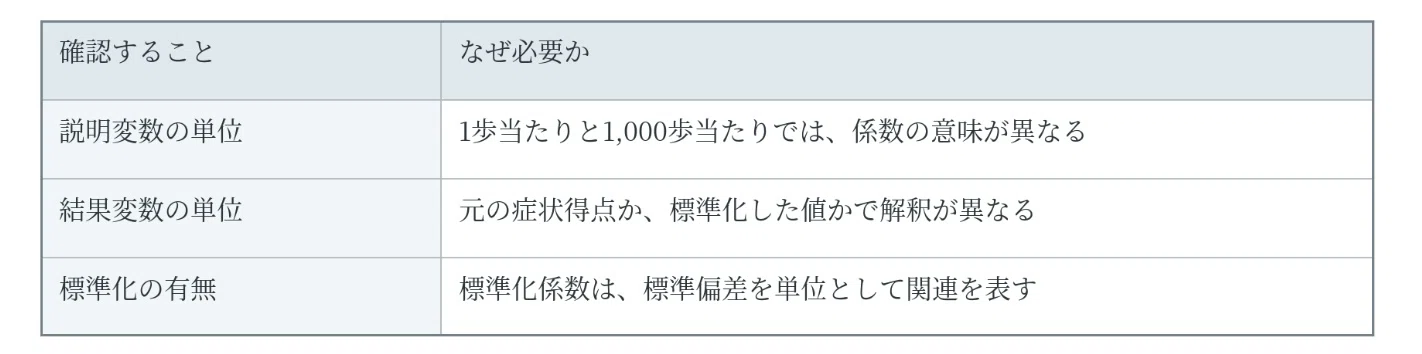
標準化回帰係数は一般にβと表記されますが、記号の使い方は論文によって異なるため、Methodsや表の注記で確かめましょう。
9.B・信頼区間・p値をまとめて解釈する
次の研究結果を考えてみます。 B=−0.080、95%信頼区間−0.109~−0.052、p<0.001
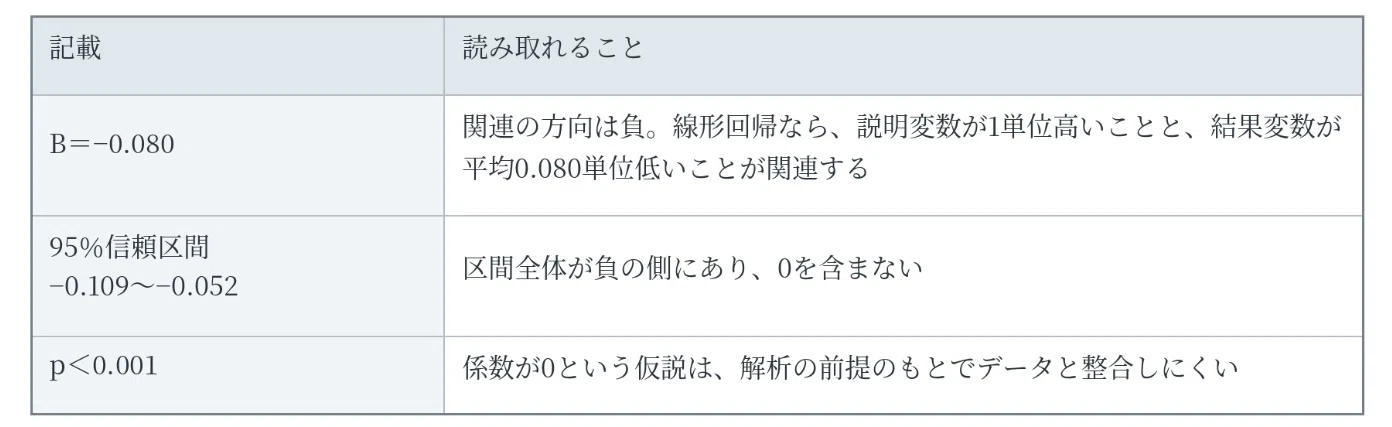
しかし、これだけでは臨床的に大きな関連かどうかは分かりません。変数の単位、対象集団、調整した要因を確認する必要があります。
三つの数値は、同じ結果を別の角度から説明しています。Bが関連の大きさ、信頼区間が不確実性、p値が帰無仮説との整合性を伝えるのです。
10.交絡と調整 〜関連の背後にある別の要因
運動量の多い人ほど抑うつ症状が軽かったとしても、運動だけが理由とは限りません。身体疾患、年齢、経済状況などが、運動量と症状の両方に関係している可能性があります。 このように、関連に別の要因の影響が混ざる問題を交絡と呼びます。
多変量解析では、複数の変数をモデルに入れ、それらを考慮した関連を推定します。「調整済み回帰係数」とは、モデル上、他の条件を一定にしたときの関連です。 ただし、調整したから因果関係が証明されるわけではありません。測定されていない交絡因子や、測定誤差は残ります。 また、運動が睡眠を改善し、その結果として抑うつが軽くなるなら、睡眠は効果を伝える媒介因子です。
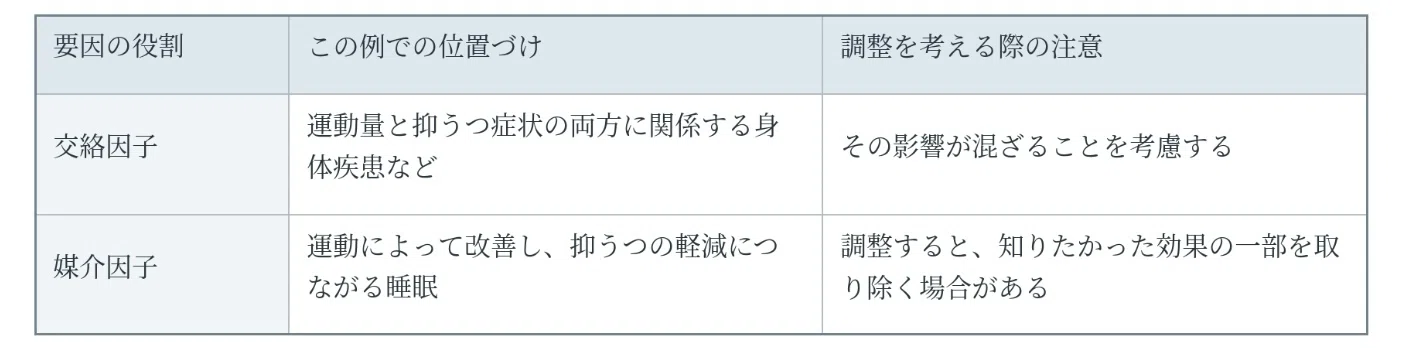
調整する変数は、単に数を増やすのではなく、因果関係の仮説に沿って選びます。
11.相関係数と決定係数 〜関連と説明できる分散
相関係数rは、二つの変数の直線的な関連を−1から+1で表します。
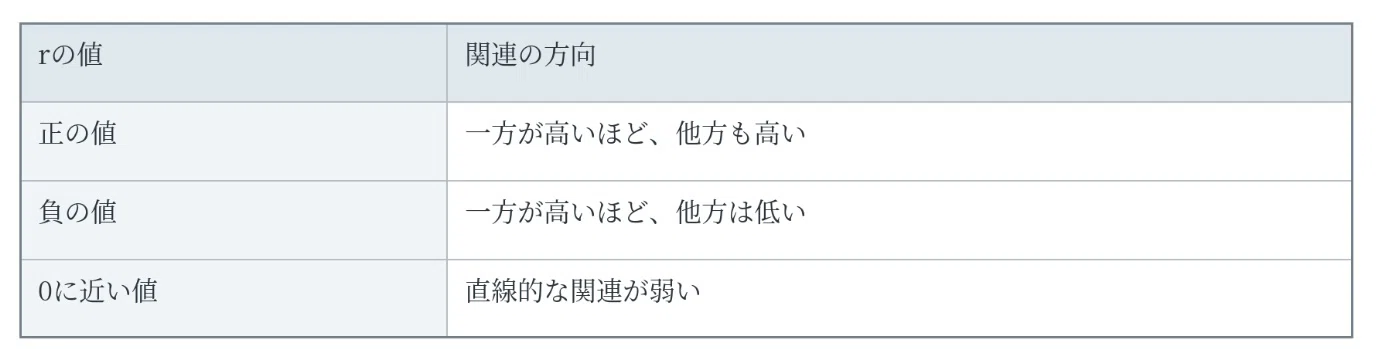
rが0に近くても、U字型などの非線形な関連がある場合はあります。また、相関が強くても、一方が他方の原因であるとは限りません。
決定係数R²は、通常の線形回帰で、結果のばらつきのどの程度をモデルが説明するかを示します。切片を含む単回帰ではR²=r²です。 r=0.30ならR²=0.09で、その直線モデルが説明する分散は9%です。 これは「病気の原因の9%を解明した」「一人の患者の症状の9%がその要因でできている」という意味ではありません。
集団内のばらつきについての説明と、個人の成り立ちについての説明を区別することが大切です。
12.リスク比・オッズ比・絶対リスク
1年間の再発割合が対照群20%、治療群10%なら、リスク比RRは0.50です。治療群の再発リスクは対照群の半分で、相対リスク減少は50%となります。
一方、絶対リスク減少は10パーセントポイントです。 その逆数であるNNT、治療必要数は10人となります。1年間に追加で1人の再発を防ぐため、平均して10人を治療するという意味です。 対照群2%、治療群1%でも相対リスク減少は50%ですが、絶対リスク減少は1パーセントポイント、NNTは100人です。(1年間に追加で1人の再発を防ぐため、平均して100人を治療する必要があるという意味)
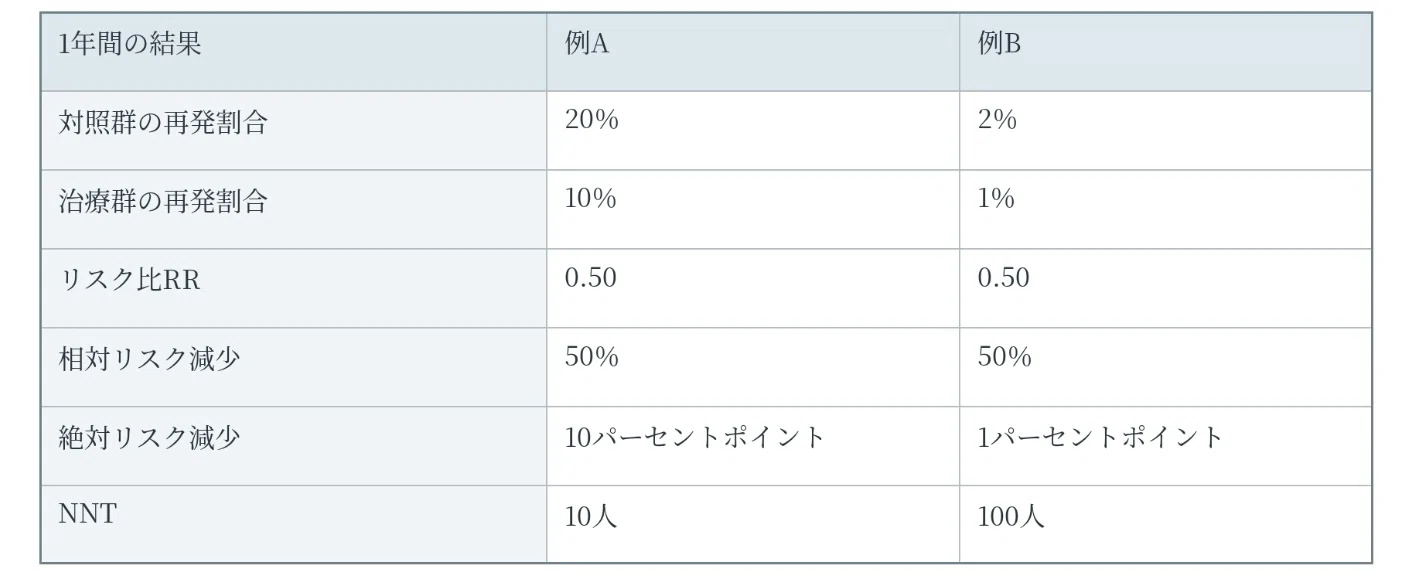
相対効果だけでは、患者さんが受ける利益の大きさを判断できません。
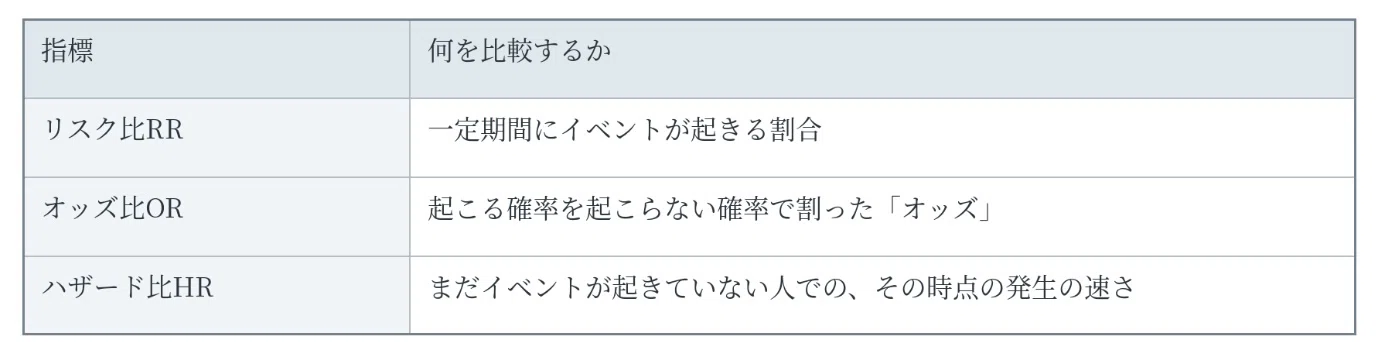
オッズ比ORは、「起こる確率を起こらない確率で割った値」の比です。イベントがまれならRRに近づきますが、頻度が高い場合は異なります。
また、ハザード比HRは、まだイベントが起きていない人における、その時点での発生の速さの比です。累積した発症割合の比と、そのまま同一視することはできません。
13.検出力と多重比較 〜有意差が生まれる条件
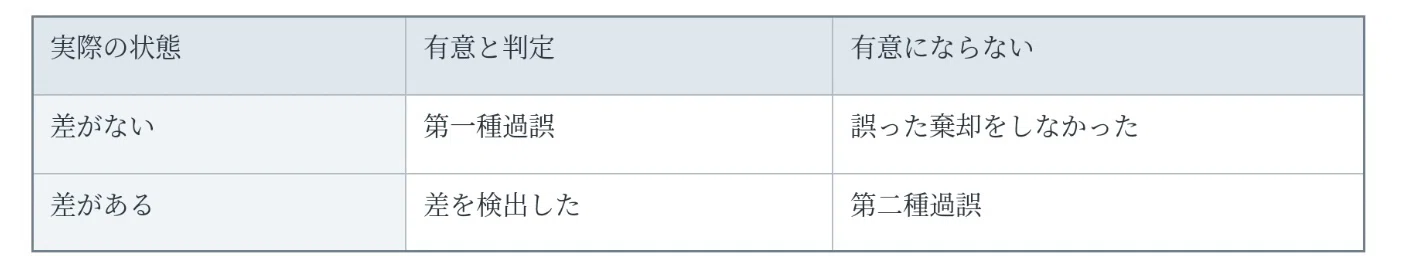
実際には差がないのに有意と判定することを第一種過誤、差があるのに有意にならないことを第二種過誤と呼びます。
検出力は、想定した効果が本当にある場合に、有意差を検出できる確率です。人数、ばらつき、効果の大きさなどによって変わります。 一方、検定を繰り返すと、偶然の有意差も出やすくなります。 すべて差がなく、検定が互いに独立している場合、20回の検定をそれぞれ有意水準5%で行うと、少なくとも一つが有意になる確率は約64%です。
多数の脳領域や遺伝子を調べる研究では、多重比較への対応が重要になります。 また、「男性では有意、女性では非有意」だけで男女の効果が違うとは言えません。人数の違いが理由かもしれず、効果の差を検討する交互作用の検定などが必要です。
14.感度・特異度と、陽性だった人の感染確率(陽性的中率)
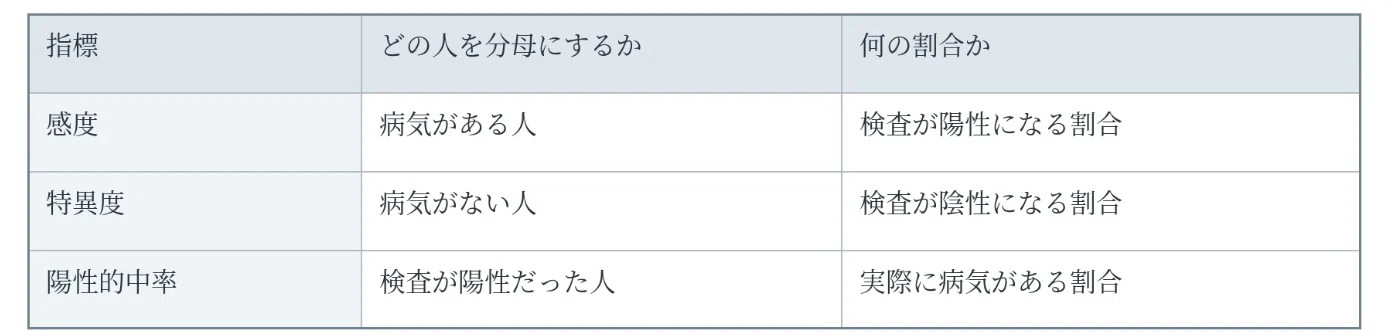
感度は、病気がある人のうち検査が陽性になる割合です。 特異度は、病気がない人のうち陰性になる割合です。 陽性的中率は、陽性と判定された人のうち実際に病気がある割合を示します。
感度90%、特異度80%の検査を、有病率1%の集団1万人に使うとします。
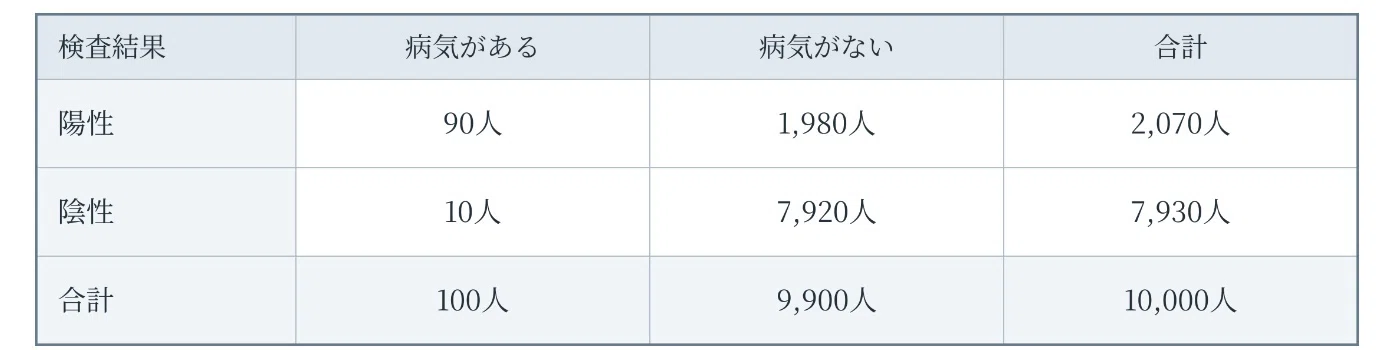
病気がある100人のうち90人が陽性となり、病気がない9,900人のうち1,980人も陽性になります。 陽性者2,070人のうち実際の患者は90人なので、陽性的中率は次のようになります。 陽性的中率= 90 ÷ 2070= 4.3% 「感度が90%だから、陽性なら90%の確率で病気」とはなりません。検査結果は、その病気を検査前にどの程度疑っていたかと合わせて解釈します。 ただ、実際の臨床現場では、陽性的中率4.3%では、この検査を行う意味は少ないと言わざるを得ません。
次に、現実に臨床現場で使われているインフルエンザ検査キットで見てみましよう。 ここでは、一般的なインフルエンザ検出キットの性能である感度60%、特異度98%として、有病率30%の集団1万人に使う場合を考えます。(有病率は、インフルエンザ流行期に診療所で検査を受ける患者さんの、便宜上の想定有病率です。時期によって大きく変化します。)
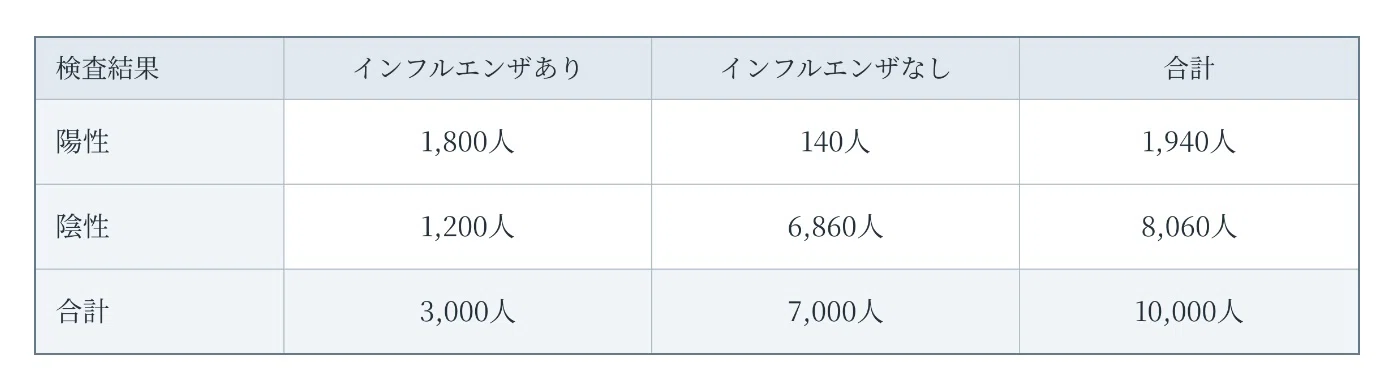
インフルエンザがある3,000人のうち、感度60%なので1,800人が陽性となり、1,200人は陰性になります。 一方、インフルエンザがない7,000人のうち、特異度98%なので6,860人が陰性となります。残る2%の140人は、インフルエンザがないにもかかわらず陽性になります。
陽性者1,940人のうち実際の患者は1,800人なので、陽性的中率は次のようになります。 陽性的中率= 1800 ÷ 1940 = 92.8% つまり、この条件では、陽性と判定された人のうち、実際にインフルエンザがある人は約93%です。検査を行う意味があると思われる値でしょう。 ただ、偽陰性率(実際インフルエンザに罹っている人の中で、陰性と結果が出る人の割合)は、感度60%なので、定義から40%となります。陰性と結果の出た人の中で、実際はインフルエンザに罹っている人の割合ではありません。 後者は、「陰性後の疾病罹患率」と定義されています。
偽陰性率は、「陰性後の疾病罹患率」とよく誤解されていますので、注意してください。 陰性後の疾病罹患率=1-陰性的中率となり、1 – 6860 ÷ 8060 = 14.9% この値は、陰性の患者さんの中で、14.9%は、インフルエンザ感染者という事を表しています。
「特異度が98%だから、陽性なら98%の確率でインフルエンザ」とはなりません。 陽性的中率は、感度と特異度に加え、検査を受ける集団の有病率によって変わります。このため検査結果は、その病気を検査前にどの程度疑っていたかと合わせて解釈します。 例えば、感度60%・特異度98%を固定すると、計算上は以下のようになります。
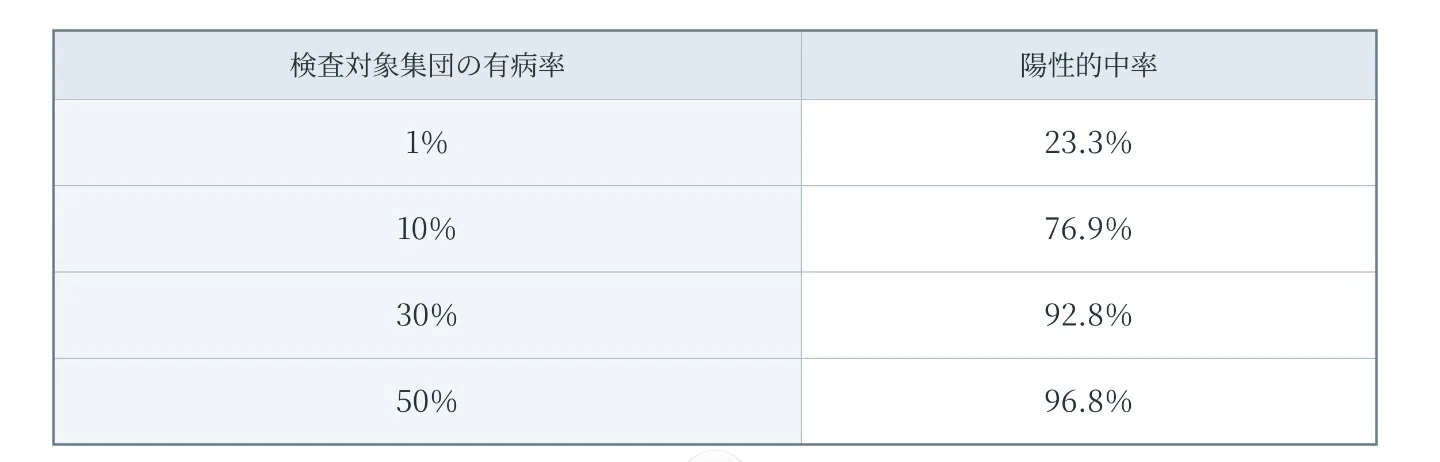
このように、統計の数字は感染状況なども含めて多角的に観察することで、実臨床への有用性は変わってきます。感度と特異度だけで、検査の有用性は判断するべきではないことを知っておいて下さい。
15.数値を、臨床の判断へ戻す
論文では、最初に誰を対象に、何と何を比較し、いつの何を評価したかを確認します。 そのうえで、効果の大きさ、信頼区間、p値を読みます。
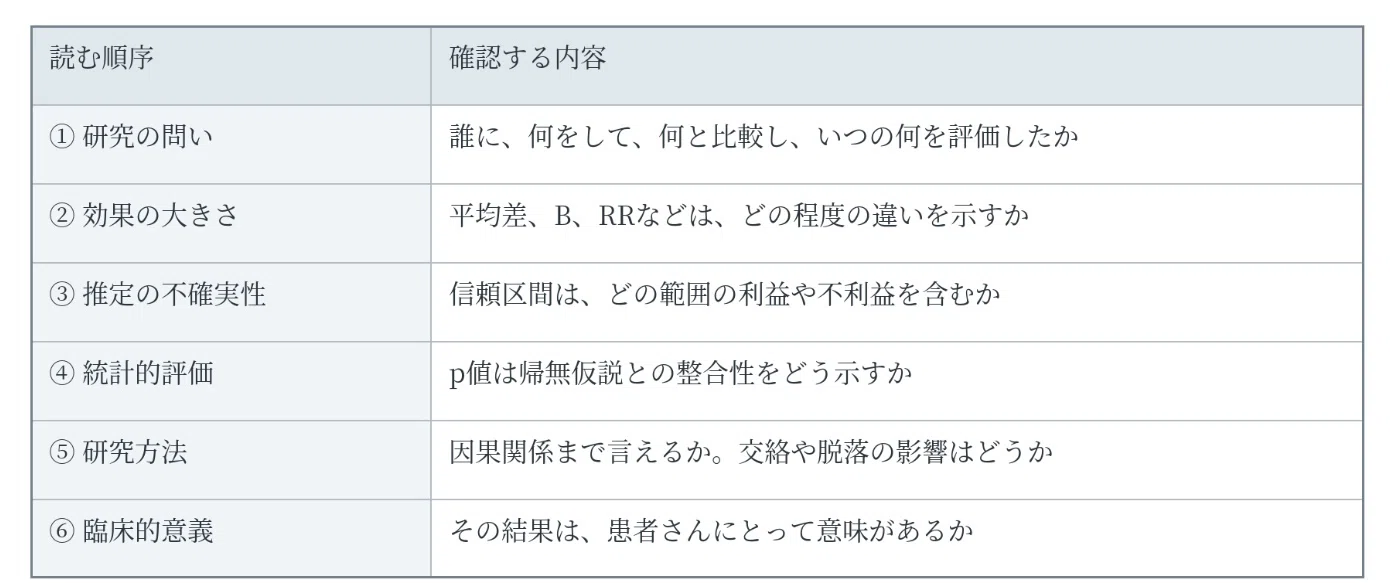
横断研究で分かる同時点の関連と、無作為化比較試験で推定する治療効果では、言えることが異なります。 治療を中断した患者さんが解析から除かれていれば、効果や忍容性を過大評価する可能性もあります。
最後に必要なのは、臨床的な意義の判断です。 統計学的に明瞭な差でも、患者さんが実感できるほど大きいとは限りません。一方、平均的な効果が小さくても、重い転帰を防げるなら重要な場合があります。
症状の改善、生活機能、再発、有害事象、費用、治療の負担を合わせて考える。その判断を支えるために、医学統計があります。 用語の意味を正確に理解し、数値を正確に読み、その数値が目の前の患者さんにとって何を意味するかを考える姿勢が、医学生のうちから育てたい力です。
著者あとがき 〜ズナノロンの治験結果をどう考えるか?
抗うつ薬ズラノロン(日本での商品名:ザズベイ)は、米国では産後うつ病を適応として承認されています。一方、日本では「うつ病・うつ状態」を適応として承認され、産後うつ病以外の患者さんにも保険診療で使用できます。
この薬の効果を考えるうえで、注目しておきたいのが、次の二つの第3相臨床試験の結果です。いずれも、投与開始15日目のうつ症状を、HAMD-17という評価尺度で調べています。
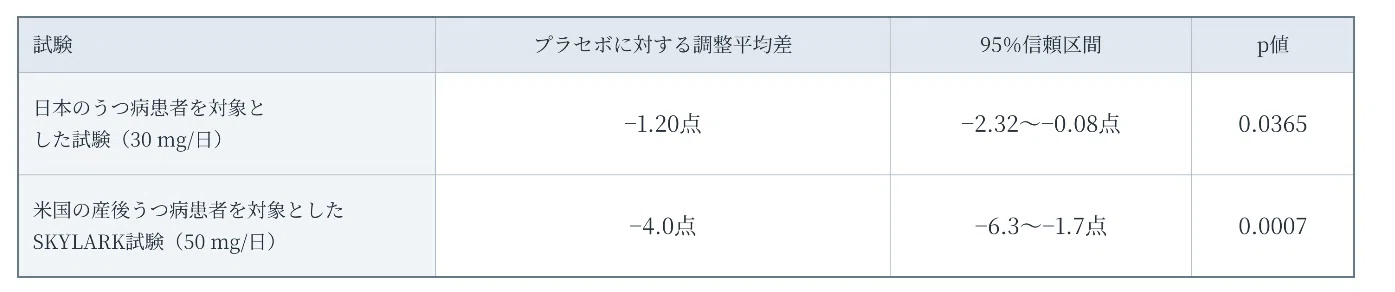
どちらの試験でも、ズラノロン群はプラセボ群より統計学的に有意な改善を示しました。 ただし、プラセボに比べてどの程度多く症状が改善したかを示す「調整平均差」は、日本の試験では1.20点、米国の産後うつ病の試験では4.0点でした。 対象患者、投与量、治療開始時の重症度などが異なるため、この数字だけで、産後うつ病とそれ以外のうつ病に対する効果の差を断定することはできません。また、p値の大小が、そのまま治療効果の大小を表すわけでもありません。 それでも、それぞれの試験で推定された改善幅と、その不確実性を示す95%信頼区間には、目を向ける必要があります。
日本では幅広く使用できる薬ですが、適応が認められているからといって、どのような患者さんにも同じ程度の効果が期待できるわけではありません。処方に際しては、臨床試験で示された効果の大きさと副作用の情報を踏まえ、目の前の患者さんにとっての利益と不利益を判断することが大切です。 統計だけで治療方針が決まるわけではありません。しかし、統計が示す知見は、臨床判断を支える重要な根拠です。
本コラムの最後に、上の二つの結果から「何が分かり、何までは言えないのか」を、あらためて考えてみてください。
[ズナノロンの臨床治験結果詳細は、コラム:新規GABA-A受容体PAM(ズラノロン)の臨床的意義と課題(比較資料:米国 産後うつ病第3相臨床治験結果)を、参照下さい。]
この内容にご興味がある方は、こちらのnotoサイト:https://note.com/mentlmap を是非ご覧ください。